
2025年博彩于赌博博彩娱乐排行榜(www.crowngamezonehomehub.com)
本文通过本人融会进行论述,如有不准确的地点,请指正。
在请教一系列干系专科术语之前,先尝试用一个下里巴人的故事来证据 Kubernetes 中 node 与 pod 之间的爱恨情仇。
雄性(node)| 雌性(pod)
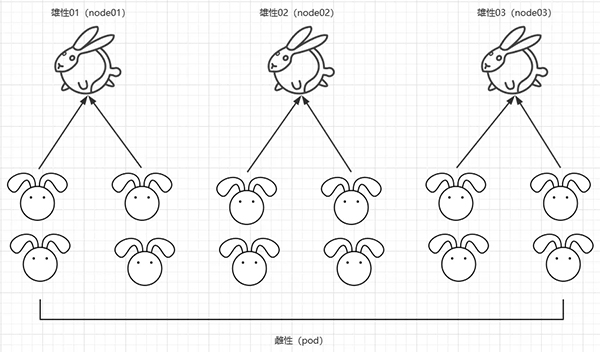
在星河系之外的一个星球上,有着一群两性生物,诀别是雌性(pod)和雄性(node)。雌性生物居多,而雄性生物由于仗强欺弱,只剩下 3 只优质的雄性生物(node)。雄雌在全部就容易产生诱骗,就会有以下的情况产生:
(1)雄(node)少雌(pod)多,而这三只优质的雄性生物脾气、优点都是一致的,雌性生物选谁都不异。于是,雌性生物就分为均瓜分为三列和三只雄性生物在全部。这种肖似于平平分拨的原则。
痛风,被称为“天下第一痛”,是指高尿酸血症患者(大多数无症状)在各种诱因的情况下,导致原本沉积在关节的晶体在体内发生急性炎性反应的情况。高尿酸血症是指正常嘌呤饮食状态下,非同日两次空腹血尿酸(SUA)水平>420μmol/L。发作时,患者会出现局部关节的突然疼痛、压痛、发红、发热和肿胀等症状。严重时足以让人痛到撕心裂肺,甚至怀疑人生。

k8s 中的观念:在 k8s 中是最常见最普通的 pod 散布神情,常用与 deployment 和 daemonset 结束器。
(2)时分一长,生物开首了进化。三只雄性(node)生物各自有了不不异的地点,编号 1 的雄性学会了训导(node01 label skill='grow');编号 2 的雄性学会了打猎(node02 label skill='hunt');编号 3 的雄性啥也没学会(没学会就保抓默许)。普通的雌性(pod)仍然保抓着平平分拨的原则。而一些进化快的雌性(pod)生物发现了三只优质雄性(node)生物各自的不同,各自也开首有了一些遴荐。一些雌性愈加宠爱学会训导的雄性生物(nodeSelector skill='grow') ;一些雌性愈加宠爱学打猎的雄性生物(nodeSelector skill='hunt') ;而有些雌性生物心爱的特色很奇特,它们心爱会飞的雄性,而仅存的三只雄性生物都无法得志这一特色。如若有天一只雄性生物进化会飞了,它们就会依附与会飞的雄性生物,如若长久莫得进化出会飞的雄性生物,则它们一直等下去这在 k8s 中,等于 yaml 文献中 nodeSelector 的使用。
k8s 中的观念:当 node 打上特定的标签后,会出现如下情况:
pod 中未指定 nodeSelector ,则保抓默许 schedule 调遣算法的神情; pod 中指定了 nodeSelector ,且指定 nodeSelector 中的 key、value 相宜某一个 node 中的某一个 key、value,则这个 pod 径直调遣到该 node; pod 中指定了 nodeSelector ,指定 nodeSelector 中的 key、value 不包含在职何一个 node 中,则这个 pod 会一直处于 padding 景况。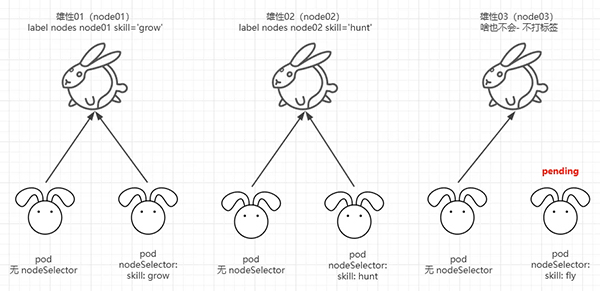
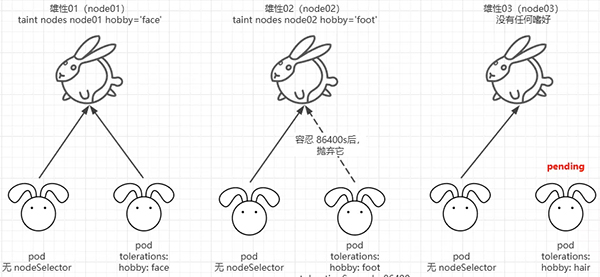
(3)三只雄性(node)不仅优点增长了,错误也随之而来。编号 1 的雄性心爱打脸(node01 taint hobby='face');编号 2 的雄性心爱打屁股(node01 taint hobby='hunkers');编号 3 的雄性心爱踩脚(node01 taint hobby='foot');普通的雌性(pod)生物仍然保抓平平分拨的原则,而一些再次进化的雌性生物也有了我方的脾气。未必容忍打脸的雌性则和编号 1 的雄性在全部(tolerations hobby='face'),但是这个容忍可能是弥远,也可能是 1 天(tolerationSeconds=86400)。而这三只雄性生物偶尔会在全部鬼混,编号 1 的雄性生物说不定哪天就嗜好就变为了心爱睡懒觉。而一些无法容忍它睡懒觉嗜好的雌性生物就会隔一段时分或者速即就离开它。
k8s 中的观念:这等于 过错 与 容忍。
将 pod 分拨给指定的节点。
集群如下:
$ kubectl get nodes NAME STATUS ROLES AGE VERSION k8s-master Ready master 20h v1.19.7 k8s-node01 Ready <none> 20h v1.19.7 k8s-node02 Ready <none> 20h v1.19.7
为 k8s-node01 添加一个标签
$ kubectl label nodes k8s-node01 disktype=ssd node/k8s-node01 labeled
稽查标签
$ kubectl get nodes --show-labels NAME STATUS ROLES AGE VERSION LABELS k8s-master Ready master 20h v1.19.7 ..., kubernetes.io/hostname=k8s-master k8s-node01 Ready <none> 20h v1.19.7 ..., disktype=ssd,kubernetes.io/hostname=k8s-node01 k8s-node02 Ready <none> 20h v1.19.7 ..., kubernetes.io/hostname=k8s-node02
不错看到 k8s-node01 节点标签:disktype=ssd
创建一个调遣到 遴荐节点的 PodapiVersion: apps/v1 kind: Deployment metadata: labels: app: ngx name: ngx spec: replicas: 2 selector: matchLabels: app: ngx template: metadata: labels: app: ngx spec: containers: - image: nginx:alpine-arm64 name: nginx nodeSelector: disktype: ssd #### 遴荐业绩 key: value 的节点
创建 pod 稽查是否调遣到指定的节点
$ kubectl apply -f ngx.yaml deployment.apps/ngx created $ kubectl get po -o wide NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES ngx-5f4df66559-hjmzg 1/1 Running 0 10s 10.244.1.13 k8s-node01 <none> <none> ngx-5f4df66559-wqgdb 1/1 Running 0 10s 10.244.1.14 k8s-node01 <none> <none>k8s 亲和性
说说念亲和性,亲和性主要分为两类:nodeAffinity 和 podAffinity 。
nodeAffinitynodeAffinity 等于节点亲和性,调遣不错分红软战术和硬战术两种神情,软战术等于如若你莫得得志调遣要求的节点的话,POD 就会忽略这条轨则,连续完成调遣经由,说白了等于得志条目最佳了,莫得的话也无所谓了的战术;而硬战术就相比果断了,如若莫得得志条目的节点的话,就不断重试直到得志条目为止,不祥说等于你必须得志我的要求,否则我就不干的战术。nodeAffinity就有两上头两种战术:
皇冠客服飞机:@seo3687 requiredDuringSchedulingIgnoredDuringExecution :硬战术 preferredDuringSchedulingIgnoredDuringExecution :软战术硬战术
apiVersion: apps/v1 kind: Deployment metadata: labels: app: ngx name: ngx spec: replicas: 2 selector: matchLabs: app: ngx template: metadata: labels: app: ngx spec: affinity: nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution: nodeSelectorTerms: - matchExpressions: - key: disktype ## key 的值 operator: In ## 包括 values: - ssd ## value containers: - image: nginx:alpine-arm64 name: nginx nodeSelector: disktype: ssd
上头这两个 pod 只会运行在 得志 node label disktype=value 的节点上,如若莫得节点得志这个条目,则一直处于 pending 景况。
$ kubectl get po -o wide NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES ngx-7b65b44bc-gff9x 1/1 Running 0 3m53s 10.244.1.15 k8s-node01 <none> <none> ngx-7b65b44bc-w7bsf 1/1 Running 0 3m53s 10.244.1.16 k8s-node01 <none> <none> $ kubectl get nodes k8s-node01 --show-labels NAME STATUS ROLES AGE VERSION LABELS k8s-node01 Ready <none> 22h v1.19.7 ..., disktype=ssd,kubernetes.io/arch=arm64,kubernetes.io/hostname=k8s-node01
软战术
博彩娱乐排行榜apiVersion: apps/v1 kind: Deployment metadata: labels: app: ngx name: ngx spec: replicas: 2 selector: matchLabels: app: ngx template: metadata: labels: app: ngx spec: affinity: nodeAffinity: preferredDuringSchedulingIgnoredDuringExecution: - weight: 10 preference: matchExpressions: - key: disktype operator: In values: - hdd containers: - image: nginx:alpine-arm64 name: nginx
软战术等于,第一遴荐是 node label disktype=hdd 的节点,如若莫得,就袭取默许 scheduler 的调遣战术,莫得强制性。
$ kubectl get po -o wide NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES ngx-d4754b6fd-lr96g 1/1 Running 0 2m55s 10.244.2.13 k8s-node02 <none> <none> ngx-d4754b6fd-ns7hs 1/1 Running 0 2m55s 10.244.1.28 k8s-node01 <none> <none>
operator 提供如下几种操作:
In:label 的值在某个列表中 NotIn:label 的值不在某个列表中 Gt:label 的值大于某个值 Lt:label 的值小于某个值 Exists:某个 label 存在 DoesNotExist:某个 label 不存在如若nodeSelectorTerms底下有多个选项的话,得志任何一个条目就不错了;如若matchExpressions有多个选项的话,则必须同期得志这些条目才能浅显调遣 POD。
过错和容忍在 Kubernetes 中,节点亲和性 NodeAffinity 是 Pod 上界说的一种属性,未必使 Pod 按咱们的要求调遣到某个节点上,而 Taints(过错) 则刚巧相背,它是 Node 上的一个属性,不错让 Pod 不可调遣到带过错的节点上,甚而会对带过错节点上已有的 Pod 进行停止。诚然,对应的 Kubernetes 不错给 Pod 开拓 Tolerations(容忍) 属性来让 Pod 未必容忍节点上开拓的过错,这么在调遣时就会忽略节点上开拓的过错,将 Pod 调遣到该节点。一般本领 Taints 频繁与 Tolerations 调和使用。
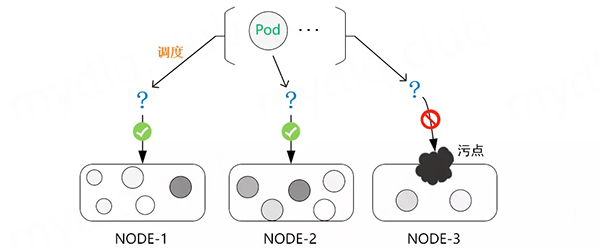
稽查过错
稽查 node 的过错
$ kubectl describe nodes k8s-master ... Taints: node-role.kubernetes.io/master:NoSchedule ... # 也可通过底下操作稽查: $ kubectl get nodes k8s-master -o go-template={{.spec.taints}} [map[effect:NoSchedule key:node-role.kubernetes.io/master]]
过错实质一般构成为 key、value 及一个 effect 三个元素,发扬为:
<key>=<value>:<effect>
这里的 value 不错为空,发扬体式为:
node-role.kubernetes.io/master:NoSchedule - key: node-role.kubernetes.io/master - value: 空 - effect: NoSchedule
开拓过错
一般咱们需要思要开拓某个节点只允许特定的 Pod 进行调遣,这本领就得对节点开拓过错,不错按 kubectl taint node [node] key=value[effect] 样式进行开拓,其中 effect 可取值如下:
PreferNoSchedule: 尽量不要调遣。 NoSchedule: 一定不可被调遣。 NoExecute: 不仅不会调遣, 还会停止 Node 上已有的 Pod。一般本领咱们开拓过错,就像底下例子不异对皆进行开拓:
### 开拓过错并不允许 Pod 调遣到该节点 $ kubectl taint node k8s-master key1=value1:NoSchedule ### 开拓过错尽量防碍过错调遣到该节点 $ kubectl taint node k8s-master key2=value2:PreferNoSchedule ### 开拓过错,不允许普通 Pod 调遣到该节点,且将该节点上仍是存在的 Pod 进行停止 $ kubectl taint node k8s-master key3=value3:NoExecute
删除过错
上头证据了如何对 Node 添加过错防碍 Pod 进行调遣,底下再说一下如何删除节点上的过错,不错使用底下高歌:
kubectl taint node [node] [key]-
上头语法和创建过错肖似,不外需要寂静的是删除过错需要知说念 key 和最背面开拓一个 "-" 两项将过错删除,示举例下:
为了简短演示,先给节点开拓过错:
### 开拓过错1 $ kubectl taint node k8s-master key1=value1:PreferNoSchedule node/k8s-master tainted ### 开拓过错2 $ kubectl taint node k8s-master key2=value2:NoSchedule node/k8s-master tainted ### 开拓过错3,皇冠导航网况兼不开拓 value $ kubectl taint node k8s-master key2=:PreferNoSchedule node/k8s-master tainted
稽查过错,不错看到上头开拓的三个值:
$ kubectl describe nodes k8s-master ... Taints: key2=value2:NoSchedule node-role.kubernetes.io/master:NoSchedule key1=value1:PreferNoSchedule key2:PreferNoSchedule ...
然后删除过错
皇冠体育hg86a
### 删除过错,不错不指定 value,指定 [effect] 值就可删除该 key[effect] 的过错 $ kubectl taint node k8s-master key1:PreferNoSchedule- ### 也不错把柄 key 径直将该 key2 的扫数 [effect] 都删除: $ kubectl taint node k8s-master key2-
再次稽查过错,不错看到以上过错都被删除:
$ kubectl describe nodes k8s-master ... Taints: node-role.kubernetes.io/master:NoSchedule ...容忍 (toleratints)
Pod 开拓容忍
为了使某些 Pod 防碍调遣到某些特定节点上,就不错对节点开拓过错 taints。诚然,如若但愿有些 Pod 未必忽略节点的过错,连续未必调遣到该节点,就不错对 Pod 开拓容忍,让 Pod 未必容忍节点上开拓的过错,举例:
韧性对一个节点开拓过错:
kubectl taint node k8s-node01 key=value:NoSchedule
关于 Pod 开拓容忍, 以下两种神情都不错:

### 容忍的 key、value 和对应 effect 也必须和过错 taints 保抓一致 ...... tolerations: - key: "key" operator: "Equal" value: "value" effect: "NoSchedule" ### 容忍 tolerations 的 key 和要过错 taints 的 key 一致,且开拓的 effect 也疏导,不需要开拓 value ...... tolerations: - key: "key" operator: "Exists" effect: "NoSchedule"
Node 和 Pod 关于过错与容忍基本观念
皇冠博彩官网观念
一个 node 不错有多个过错; 一个 pod 不错有多个容忍; kubernetes 试验多个过错和容忍次序肖似于过滤器如若一个 node 有多个过错,且 pod 上也有多个容忍,只消 pod 中容忍能包含 node 上开拓的全部过错,就不错将 pod 调遣到该 node 上。如若 pod 上开拓的容忍不未必包含 node 上开拓的全部过错,且 node 上剩下不可被包含的过错 effect 为 PreferNoSchedule,那么也可能会被调遣到该节点。
寂静
当 pod 总存在 容忍,率先 pod 会遴荐莫得过错的节点,然后再次遴荐容忍过错的节点。
如若 node 上带有过错 effect 为 NoSchedule,而 pod 上不带反映的容忍,kubernetes 就不会调遣 pod 到这台 node 上。 如若 Node 上带有过错 effect 为 PreferNoShedule,这本领 Kubernetes 会奋勉不要调遣这个 Pod 到这个 Node 上。 如若 Node 上带有过错 effect 为 NoExecute,这个仍是在 Node 上运行的 Pod 会从 Node 上停止掉。莫得运行在 Node 的 Pod 不可被调遣到这个 Node 上。一般使用与当某个节点处于 NotReady 景况下,pod 马上在其他浅显节点启动。Deployment 中开拓容忍
在 kubernetes 中 deployment 开拓容忍,示举例下:
apiVersion: apps/vl kind: Deployment metadata: name: example spec: replicas: 5 template: spec: ...... tolerations: - key: "key" operator: "Equal" value: "value" effect: "NoSchedule"
开拓容忍时分
浅显情况下, 如若一个过错带有 effect=NoExecute 被添加到了这个 Node。那么不可容忍这个过错的扫数 Pod 就会立即被踢掉。而带有容忍标签的 Pod 就不会踢掉。但是,一个带有 effect=Noexecute 的容忍不错指定一个 tolerationSeconds 来指定当这个过错被添加的本领在多永劫老实不被踢掉。举例:
tolerations: - key: "key" operator: "Equal" value: "value" effect: "Noexecute" tolerationSeconds: 3600
如若这个 Pod 仍是在这个带过错且 effect 为 NoExecute 的 node 上。这个 pod 不错一直运行到 3600s 后再被踢掉。如若这本领 Node 的过错被移除了,这个 Pod 就不会被踢掉。
容忍示例
Operator 默许是 Equal,可开拓为 Equal 与 Exists 两种,按这两种进行示例:
ag官网Operator 是 Exists
容忍任何过错
举例一个空的 key,将匹配扫数的 key、value、effect。即容忍任何过错。
tolerations: - operator: "Exists"
容忍某 key 值的过错
举例一个空的 effect,况兼 key 不为空,那么将匹配扫数与 key 疏导的 effect:
皇冠足球tolerations: - key: "key" operator: "Exists"
Operator 是 Equal
node 上有一个过错
Node 和 Pod 的 key 为 key1、value1 与 effect 疏导则能调遣:
#过错 key1=value1:NoSchedule #Pod开拓 tolerations: - key: "key1" operator: "Equal" value: "value1" effect: "NoSchedule"
node 上有多个过错
Node 的过错的 key、value、effect 和 Pod 容忍都疏导则能调遣:
## 开拓过错 key1=value1:NoSchedule key2=value2:NoExecute ## Pod开拓容忍 tolerations: - key: "key1" operator: "Equal" value: "value1" effect: "NoSchedule" - key: "key2" operator: "Equal" value: "value2" effect: "NoExecute"
Node 的过错和 Pod 的大部分都疏导,不同的是 Node 过错 effect 为 PreferNoSchedule 的,可能会调遣:
博彩于赌博www.crowngamezonehomehub.com## 过错 key1=value1:NoSchedule key2=value2:NoExecute key3=value3:PreferNoSchedule ## Pod开拓容忍 tolerations: - key: "key1" operator: "Equal" value: "value1" effect: "NoSchedule" - key: "key2" operator: "Equal" value: "value2" effect: "NoExecute"
Node 的过错和 Pod 的大部分都疏导,不同的是 Node 过错 effect 为 NoSchedule 和 NoExecute 的,不会被调遣:
## 过错 key1=value1:NoSchedule key2=value2:NoExecute key3=value3:PreferNoSchedule ## Pod开拓容忍 tolerations: - key: "key1" operator: "Equal" value: "value1" effect: "NoSchedule" - key: "key3" operator: "Equal" value: "value3" effect: "PreferNoSchedule"
对比融会 Exists 和 Equal 之间的区别:
Exists 是包含,Equal 是等于,Exists 使用范围更广,而 Equal 则是精确匹配。 当过错中存在 NoExecute 时,而容忍中不存在 NoExecute 时,不会被调遣到该节点。 Exists 不错不写 value , 而 Equal 则一定要指定对应的 value过错停止
在使用 kubernetes 时,会遭受 某个 node 节点明明仍是 宕机了,稽查 node 景况从 Ready 景况变为 NotReady 景况,但是 节点所在的 pod 却仍是处于 running 景况,过了很长一段时分才会转为 Terminating 景况,这是为什么呢?
过错是关于 node 节点来讲,如若 node 节点 effect 开拓为 NoExecute ,它会影响节点上仍是运行的 Pod,如下所示:
立行将莫得匹配容忍的 pod 停止。 开拓容忍但是莫得指定 tolerationSeconds 参数的,那么该容忍弥远见效,不会被停止。 开拓容忍但是有指定 tolerationSeconds 参数的,那么在指定的时老实容忍有用,跨越指定时分后将被剔除。(pod 默许开拓,tolerationSeconds = 300s)此外,当某些条目为 true 时,节点结束器会自动玷辱节点。内置以下过错:
key 扫视 node.kubernetes.io/not-ready 节点尚未准备好。这对应于 NodeCondition Ready 为 false。 node.kubernetes.io/unreachable 无法从节点结束器走访节点。这对应于 NodeCondition Ready 为 Unknown。 node.kubernetes.io/out-of-disk 节点磁盘不及。 node.kubernetes.io/memory-pressure 节点有内存压力。 node.kubernetes.io/disk-pressure 节点有磁盘压力。 node.kubernetes.io/network-unavailable 节点的齐集不可用。 node.kubernetes.io/unschedulable 节点不可调遣。 node.cloudprovider.kubernetes.io/uninitialized 当 kubelet 从 "外部" 云提供才智开首时,此过错在节点上开拓为将其标志为不可用。来自 cloud-controller-manager 的结束器运改革此节点后,kubelet 删除此过错。通过上头学问的铺垫,当一个节点宕机时,kubernetes 集群会给它打上什么样的过错呢?
一个 Ready 景况的节点
$ kubectl get node k8s-node02 -o go-template={{.spec.taints}} <no value>
一个 NotReady 景况的节点
$ kubectl get node k8s-node02 -o go-template={{.spec.taints}} [map[effect:NoSchedule key:node.kubernetes.io/unreachable timeAdded:2021-12-23T13:49:58Z] map[effect:NoExecute key:node.kubernetes.io/unreachable timeAdded:2021-12-23T13:50:03Z]]
处于 NotReady 景况的节点被打上了底下两个过错:
Taints: node.kubernetes.io/unreachable:NoExecute node.kubernetes.io/unreachable:NoSchedule
接下来测试 kubernetes 集群会给 Pod 分拨什么样的容忍。
在今年的欧洲杯中,几支强队展现出了非常出色的表现,特别是那些年轻的球员们,他们在比赛中的精彩发挥给观众留下了深刻印象,也成为了人们热议的话题之一。$ kubectl get po nginx-745b4df97d-mgdmp -o yaml ... tolerations: - effect: NoExecute key: node.kubernetes.io/not-ready operator: Exists tolerationSeconds: 300 ## 300/60=5min - effect: NoExecute key: node.kubernetes.io/unreachable operator: Exists tolerationSeconds: 300 ## 300/60=5min ...
看到这里,Pod 的失效机制仍是很显着了, 当 node 节点处于 NotReady 景况或者 unreachable 景况时,Pod 会容忍它 5 分钟,然后被停止。而这 5 分钟内就算 Pod 处于 running 景况,亦然无法浅显提供业绩的。因此,不错在 yaml 清单中 手动指明 0 容忍,清单文献如下:
apiVersion: apps/v1 kind: Deployment metadata: labels: app: nginx name: nginx spec: replicas: 4 selector: matchLabels: app: nginx template: metadata: labels: app: nginx spec: tolerations: - effect: NoExecute key: node.kubernetes.io/not-ready operator: Exists tolerationSeconds: 0 - effect: NoExecute key: node.kubernetes.io/unreachable operator: Exists tolerationSeconds: 0 containers: - image: nginx:alpine name: nginx
生成 Pod
$ kubectl get po -o wide NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES nginx-84f6f75c6-c76fm 1/1 Running 0 6s 10.244.3.16 k8s-node02 <none> <none> nginx-84f6f75c6-hsxq5 1/1 Running 0 6s 10.244.3.15 k8s-node02 <none> <none> nginx-84f6f75c6-wkt52 1/1 Running 0 6s 10.244.1.63 k8s-node01 <none> <none> nginx-84f6f75c6-xmkjs 1/1 Running 0 6s 10.244.3.17 k8s-node02 <none> <none>
接下来强制关闭 k8s-node02 节点,稽查 Pod 是否转化。
$ kubectl get po -o wide NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES nginx-84f6f75c6-c76fm 1/1 Terminating 0 116s 10.244.3.16 k8s-node02 <none> <none> nginx-84f6f75c6-csqf4 1/1 Running 0 13s 10.244.1.66 k8s-node01 <none> <none> nginx-84f6f75c6-hsxq5 1/1 Terminating 0 116s 10.244.3.15 k8s-node02 <none> <none> nginx-84f6f75c6-r2v4p 1/1 Running 0 13s 10.244.1.64 k8s-node01 <none> <none> nginx-84f6f75c6-v4knq 1/1 Running 0 13s 10.244.1.65 k8s-node01 <none> <none> nginx-84f6f75c6-wkt52 1/1 Running 0 116s 10.244.1.63 k8s-node01 <none> <none> nginx-84f6f75c6-xmkjs 1/1 Terminating 0 116s 10.244.3.17 k8s-node02 <none> <none>
在 node 节点转为 NotReady 景况后,Pod 坐窝进行了转化。这是通过 在 yaml 清单文献中明确指定 容忍时分。还不错径直修改 apiserver 设置来修改默许容忍时分。
vim /etc/kubernetes/manifests/kube-apiserver.yaml ... spec: containers: - command: - kube-apiserver - --advertise-address=192.168.1.11 - --default-not-ready-toleration-seconds=1 ## 新增行 - --default-unreachable-toleration-seconds=1 ## 新增行 ...
修改保存后, kube-apiserver-k8s-masterpod 会自动重载最新设置。
$ kubectl get po nginx-84f6f75c6-wkt52 -o yaml ... tolerations: - effect: NoExecute key: node.kubernetes.io/not-ready operator: Exists tolerationSeconds: 0 - effect: NoExecute key: node.kubernetes.io/unreachable operator: Exists tolerationSeconds: 0 ...
关于袖珍集群,不错径直开拓全局变量。
寂静:当 kubernetes 集群唯有一个 node 节点时皇冠体育官网,无法作念到 Pod 转化,因为 Pod 仍是无路可退了。
上一篇:cba博彩 网站外国博彩平台(www.crowncasinokingzonezone.com) 下一篇:没有了
-
热点资讯
-
相关资讯
